
Ce qui s’est passé
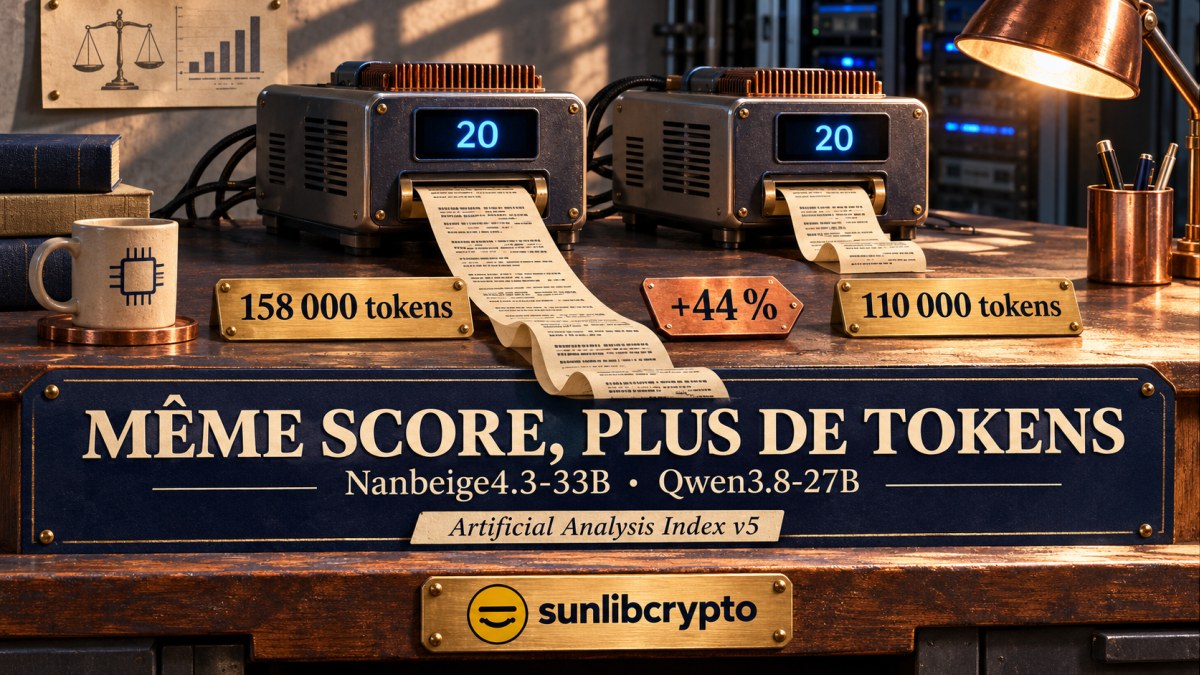
Événement daté le 09/11/2026 : « Nanbeige4.3-33B égale Qwen3.8-27B sur l'index d'IA mais consomme 44 % de jetons en plus ».
Publié le 9 novembre 2026, le rapport met en lumière une égalité de performance entre deux modèles d'IA de grande envergure, tout en soulignant une disparité significative dans la consommation de jetons, un facteur crucial pour quiconque exécute ces modèles localement.
- Score identique sur l'Intelligence Index : Les deux modèles atteignent un score de 20 sur l'évaluation v5 d'Artificial Analysis, plaçant Nanbeige au-dessus de nombreux autres modèles comme Muse Glimmer et établissant un nouveau point optimal de Pareto pour les modèles denses.
- Nanbeige utilise 44 % de jetons en plus : Nanbeige4.3-33B génère 158 000 jetons de sortie par tâche contre 110 000 pour Qwen3.8-27B, ce qui, sur le même matériel, pourrait augmenter le temps d'inférence d'environ 1,7 fois en raison de l'augmentation des lectures de poids et du décodage.
Pourquoi ces conseils maintenant ? Après cette actualité, évaluez les besoins en mémoire de votre système, les coûts en jetons et les temps d'inférence réels sur votre charge de travail avant de choisir entre les deux modèles pour des tâches terminales ou sensibles à la latence.
Mis à jour le 09/11/2026
Réponse rapide
Les deux modèles offrent des performances comparables, mais Nanbeige consomme environ 1,7 fois plus de ressources compute en raison de sa production de jetons plus élevée. Pour les charges de travail intensives en termes de terminal et d'agentic, les forces de Nanbeige peuvent justifier les coûts plus élevés ; pour les tâches sensibles à la latence ou à la connaissance, Qwen est plus efficace.
👉 Utiliser le centre d’outils SunLibCrypto
Ce qu’il faut remettre dans son contexte
Nanbeige4.3-33B et Qwen3.8-27B atteignent tous deux un score de 20 sur l'Intelligence Index v5, mais Nanbeige génère 158 000 jetons de sortie contre 110 000 pour Qwen, soit 44 % de jetons en plus. Cette différence augmente le temps d'inférence, la consommation d'électricité et le coût du matériel pour l'inférence locale, rendant le choix entre les deux modèles plus complexe qu'il n'y paraît.
L'erreur la plus courante survient lorsqu'un utilisateur télécharge le fichier de poids de 66 Go de Nanbeige sans d'abord vérifier la disponibilité de la mémoire, ce qui bloque le démarrage du modèle sur un PC standard. ou lorsqu'il exécute le modèle avec la quantification BF16, épuisant la VRAM et ralentissant les tâches locales.
Le contrôle en pratique
- Vérifier le poids du modèle et la mémoire requise Téléchargez la version quantifiée (par exemple, 4-bit) de Nanbeige4.3-�ונה, qui occupe environ 17 Go, avant d'installer le modèle sur un système doté d'au moins 24 Go de RAM unifiée.
- Tester la consommation de tokens sur votre matériel Exécutez une tâche de référence avec les deux modèles et mesurez les jetons de sortie par requête ; notez que Nanbeige génère environ 44 % de tokens en plus.
- Adapter la quantisation et le parallélisme Utilisez vLLM ou SGLang avec un tensor parallelism de quatre GPU pour maintenir des temps d'inférence raisonnables et réduire la lecture des poids.
- Surveiller les coûts en temps réel Configurez un moniteur d'utilisation du GPU pour enregistrer la consommation de VRAM et les secondes par tâche, afin de calculer le coût énergétique réel.
- Valider sur des charges de travail réelles Exécutez une charge de travail typique (par exemple, Terminal‑Bench) et comparez le score, les jetons et les secondes pour décider quel modèle convient mieux à vos besoins.
Les pièges à garder en tête
- Supposer qu'un score identique signifie des coûts identiques.
- Ignorer l'impact des jetons supplémentaires sur le temps et l'électricité.
- Négliger les effets de la quantification sur les performances et la taille des jetons.
Ignorer l'écart de jetons peut entraîner une augmentation de 1,7 fois du temps d'inférence, une surchauffe du matériel et des factures d'électricité plus élevées, rendant le modèle moins pratique pour une utilisation locale.
Ce que je vérifierais en premier
- Confirmez les nombres de jetons (158k contre 110k) pour chaque modèle.
- Mesurez le temps d'inférence réel sur votre matériel cible.
- Vérifiez les besoins en mémoire pour les versions quantifiées (par exemple, 4-bit).
- Comparez les scores par tâche pour voir où chaque modèle excelle.
Suivre la checklist permet d'éviter de sous-estimer les besoins en tokens, de surchauffer le matériel et de gaspiller de l'électricité. Elle vérifie aussi la compatibilité du modèle avec la mémoire, la version de quantisation et la vitesse d'inférence avant le déploiement.
Passer de la lecture au contrôle
Ouvrir le centre d’outils SunLibCrypto
Un moniteur GPU comme 'nvidia-smi' ou un tableau de bord software enregistre les secondes par tâche et la consommation de VRAM, vous permettant d'estimer les coûts en tokens avant l'inference complète.
Pour approfondir
- Définition : Risque de contrepartie : comprendre ce terme avant de continuer.
- Débuter en crypto : reprendre les bases avant une opération.
- Checklist avant transfert : éviter les erreurs d’adresse, réseau ou mémo.
- Assistant anti-arnaque : analyser un doute avant de payer ou signer.
À retenir pour la suite
En pesant le score d'intelligence contre la production de jetons, vous pouvez choisir le modèle qui correspond à vos contraintes matérielles et budgétaires, garantissant une inférence locale efficace et économique. Cette approche équilibrée vous évite aussi les surprises de surcoût et vous permet d'adapter le modèle à des tâches terminales ou de raisonnement intensif.
Questions autour de Nanbeige4.3-33B contre Qwen3.8-27B
Qu'indique un score de 20 sur l'Intelligence Index v5 ?
Il s'agit d'une moyenne pondérée de neuf évaluations de raisonnement, plaçant le modèle parmi les meilleurs pour les capacités d reasoning dense.
Pourquoi Nanbeige utilise-t-il plus de jetons que Qwen ?
Nanbeige produit des chaînes de raisonnement plus longues, ce qui entraîne environ 44 % de jetons de sortie en plus par tâche.
Comment puis-je exécuter Nanbeige sur un PC local ?
Téléchargez les poids BF16 (66 Go) ou quantifiez-les en 4-bit (~17 Go) et utilisez vLLM/SGLang sur une seule ou plusieurs GPU.